
مدل Inkling 2 Small، خط لوله GLM-5.5 و بهروزرسانیهای استنتاج MoE روی SSD
خلاصه هوش مصنوعی
این مقاله به تحولات اخیر در زمینه مدلهای متنباز و سیستمهای استنتاج، از جمله مدل Inkling 2 Small، خط لوله آموزشی GLM-5.5 و استریمینگ مدلهای Mixture-of-Experts (MoE) مبتنی بر llama.cpp از روی SSD میپردازد. همچنین معیارهای سرویسدهی عاملمحور و تجربیات عملی با ابزارهای کدنویسی خودکار مانند Codex در مقایسه با Claude Code بررسی شدهاند.
نکات کلیدی
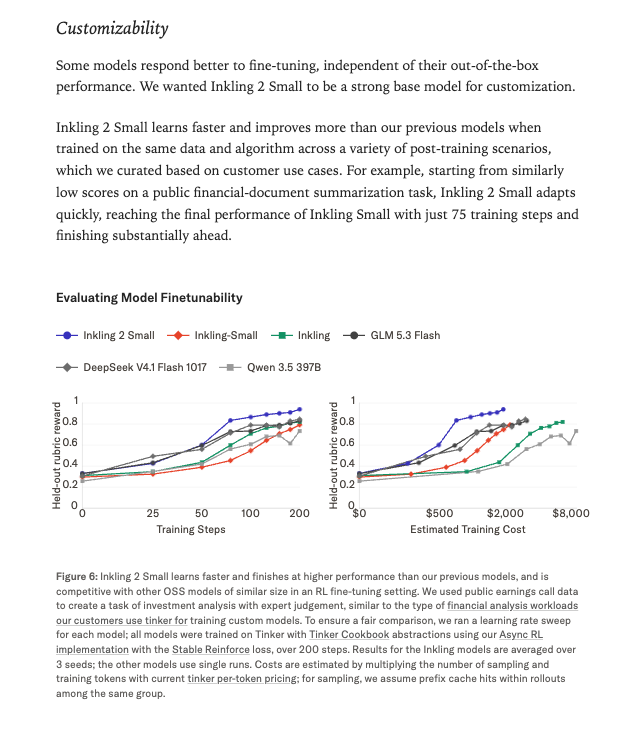
- مدل Inkling 2 Small قابلیت سفارشیسازی هدفمند و عملکرد رقابتی را در میان مدلهای متنباز ارائه میدهد.
- رویکرد موتور استنتاج MoE مبتنی بر SSD میتواند ۶۰ تا ۷۰ درصد از متخصصان مسیریابیشده را با سربار استریمینگ بسیار کم به حافظه جانبی منتقل کند.
- تجربیات مقایسهای توسعهدهندگان، تضادهای قابل توجهی را بین دستیاران کدنویسی خودکار مانند Codex و Claude Code نشان میدهد.
چرا مهم است
آگاهی از پیشرفتهای آموزش پیشفرض مدلها، خارجسازی بار سختافزاری برای استنتاج MoE و استراتژیهای سرویسدهی عاملمحور به مهندسان کمک میکند تا استقرار محروطه و ابری خود را تحت محدودیتهای شدید منابع بهینه کنند.
گفتگو 0
آغازگر گفتگو باشید.