
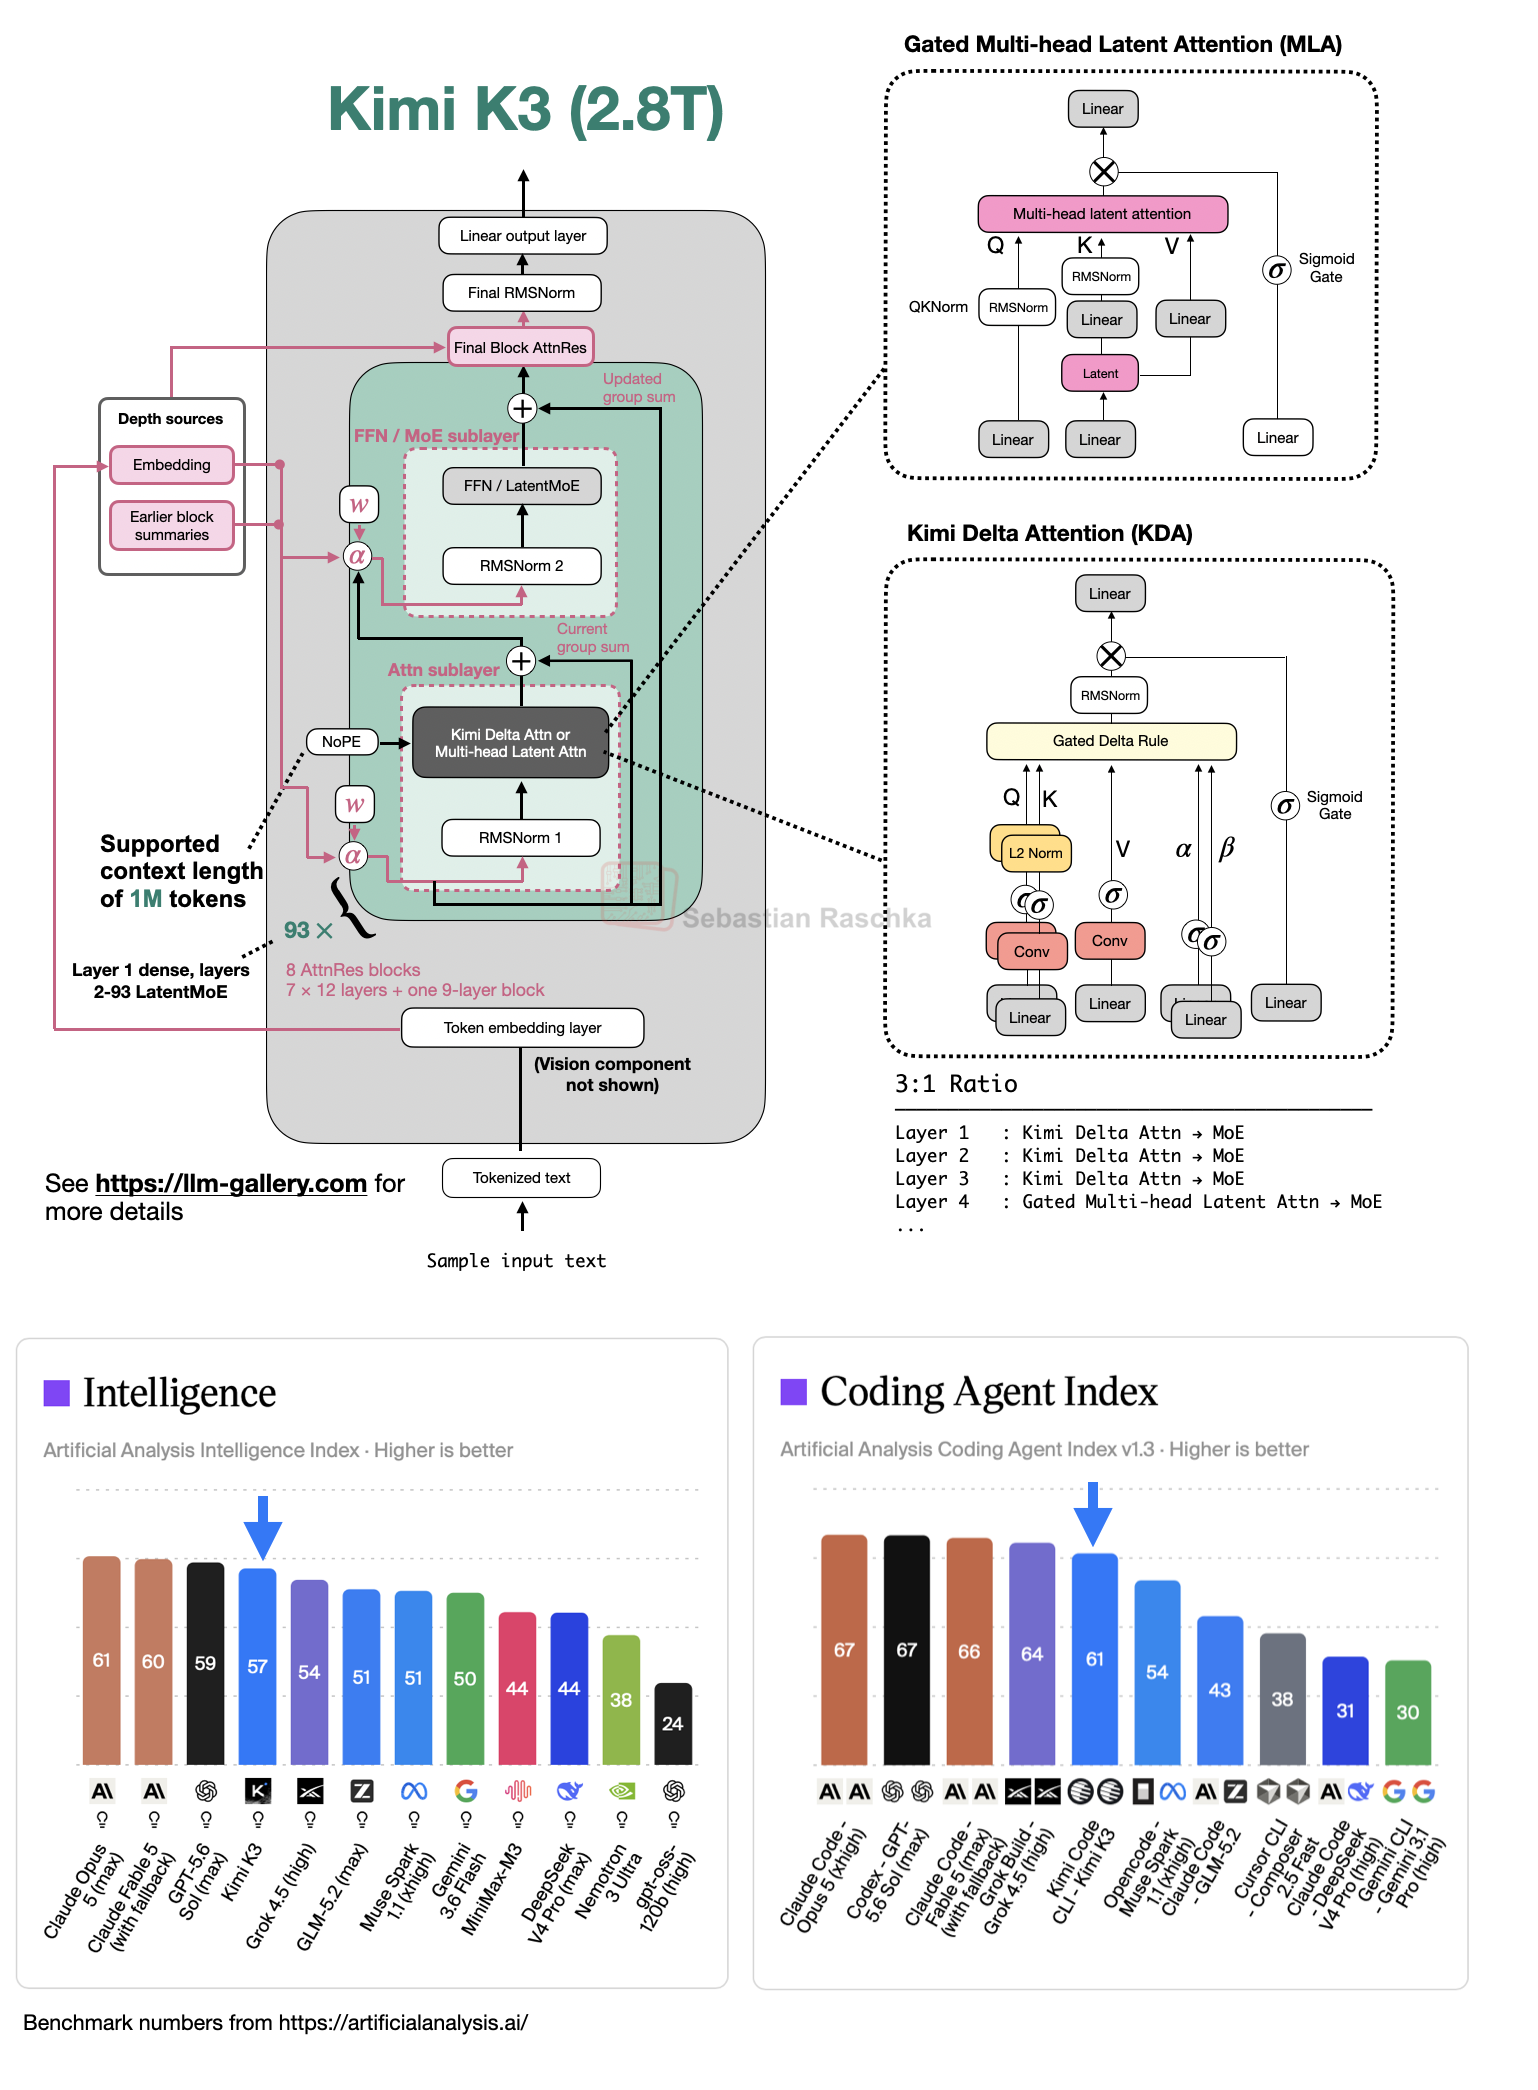
نکات معماری Kimi K3
خلاصه هوش مصنوعی
بررسی معماری مدل متنباز Kimi K3 که از مدل Kimi Linear به ۲.۸ تریلیون پارامتر مقیاسپذیری شده است. این مدل LatentMoE را برای فشردهسازی لایههای خطی بزرگ معرفی میکند، از بقایای توجه (attention residuals) برای اتصال بقایا در لایهها استفاده میکند و بهطور کامل لایههای RoPE را حذف کرده و بهجای آن از NoPE (بدون تعبیههای موقعیتی) در سراسر مدل بهره میبرد. همچنین این مدل از قابلیت پشتیبانی بومی چندوجهی برخوردار است.
نکات کلیدی
- مقیاسیافته از مدل Kimi Linear از ۴۸ میلیارد به ۲.۸ تریلیون پارامتر.
- جایگزینی اجزای استاندارد با نسخههای بهینهشده از نظر کارایی مانند LatentMoE، توجه نهفته چندسر و توجه Kimi Delta.
- حذف کامل لایههای RoPE و استفاده از NoPE در کل معماری.
چرا مهم است
آشنایی با تصمیمات معماری پشت یک مدل عظیم ۲.۸ تریلیون پارامتری مانند Kimi K3 بینش ارزشمندی درباره روندهای فعلی صنعت در زمینه کارایی استنتاج، تعبیههای موقعیتی جایگزین (NoPE) و اتصالات باقیمانده پیشرفته فراهم میکند.
گفتگو 0
آغازگر گفتگو باشید.